Навигация по курсу
На телефоне широкие таблицы и схемы прокручивайте влево и вправо.
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 08.09 | Вт | 16:00–17:35 | Лекция | Л.1. Основные понятия баз данных и СУБД |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 15.09 | Вт | 12:30–14:05 | Лаб. | ЛР №1. SSMS: системные и учебные БД | |
| 16.09 | Ср | 14:15–15:50 | Лекция | Л.2. Реляционная модель. Функциональные зависимости | |
| 16.09 | Ср | 16:00–17:35 | Лаб. | ЛР №2. Таблицы и первый SELECT |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 22.09 | Вт | 14:15–15:50 | Лекция | Л.3. Нормализация. Аномалии обновления | |
| 22.09 | Вт | 16:00–17:35 | Лаб. | ЛР №3. DDL: CREATE, типы, ограничения | |
| 23.09 | Ср | 12:30–14:05 | Лаб. | ЛР №4. FK, ALTER TABLE, GO |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 29.09 | Вт | 12:30–14:05 | Лекция | Л.4. Многопользовательские и распределённые БД | |
| 29.09 | Вт | 14:15–15:50 | Лаб. | ЛР №5. INSERT, SELECT, WHERE | |
| 30.09 | Ср | 12:30–14:05 | Лаб. | ЛР №6. UPDATE, DELETE, ORDER BY |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 06.10 | Вт | 12:30–14:05 | Лекция | Л.5. Транзакции. Свойства ACID | |
| 06.10 | Вт | 14:15–15:50 | Лаб. | ЛР №7. Агрегатные функции | |
| 06.10 | Вт | 16:00–17:35 | Лаб. | ЛР №8. GROUP BY, HAVING, ROLLUP |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 13.10 | Вт | 12:30–14:05 | Лекция | Л.6. Аномалии параллельного доступа | |
| 13.10 | Вт | 14:15–15:50 | Лаб. | ЛР №9. Вложенные подзапросы | |
| 14.10 | Ср | 12:30–14:05 | Лаб. | ЛР №10. Коррелированные подзапросы и EXISTS |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 20.10 | Вт | 12:30–14:05 | Лекция | Л.7. Уровни изоляции транзакций | |
| 20.10 | Вт | 14:15–15:50 | Лаб. | ЛР №11. INNER и OUTER JOIN | |
| 21.10 | Ср | 12:30–14:05 | Лаб. | ЛР №12. UNION, EXCEPT, INTERSECT |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 27.10 | Вт | 12:30–14:05 | Лекция | Л.8. Блокировки, тупики, репликация | |
| 27.10 | Вт | 14:15–15:50 | Лаб. | ЛР №13. Функции строк, чисел, дат | |
| 28.10 | Ср | 12:30–14:05 | Лаб. | ЛР №14. CASE, ISNULL, COALESCE |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 03.11 | Вт | 12:30–14:05 | Лекция | Л.9. Структурированные и неструктурированные данные | |
| 03.11 | Вт | 14:15–15:50 | Лаб. | ЛР №15. Переменные и IF | |
| 04.11 | Ср | 12:30–14:05 | Лаб. | ЛР №16. Циклы WHILE и TRY/CATCH |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 10.11 | Вт | 12:30–14:05 | Лекция | Л.10. Язык XML | |
| 10.11 | Вт | 14:15–15:50 | Лаб. | ЛР №17. XML в SQL Server | |
| 11.11 | Ср | 12:30–14:05 | Лаб. | ЛР №18. Иерархические данные |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 17.11 | Вт | 12:30–14:05 | Лекция | Л.11. Администрирование и мониторинг СУБД | |
| 17.11 | Вт | 14:15–15:50 | Лаб. | ЛР №19. MongoDB — документная БД | |
| 18.11 | Ср | 12:30–14:05 | Лаб. | ЛР №20. Представления VIEW |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 24.11 | Вт | 12:30–14:05 | Лекция | Л.12. Программирование в БД: процедуры, триггеры | |
| 24.11 | Вт | 14:15–15:50 | Лаб. | ЛР №21. Хранимые процедуры | |
| 01.12 | Вт | 12:30–14:05 | Лаб. | ЛР №22. Триггеры DML и INSTEAD OF |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 01.12 | Вт | 14:15–15:50 | Лекция | Л.13. Резервное копирование | |
| 02.12 | Ср | 12:30–14:05 | Лаб. | ЛР №23. GRANT, REVOKE, роли |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 08.12 | Вт | 12:30–14:05 | Лекция | Л.14. Восстановление данных и защита | |
| 08.12 | Вт | 14:15–15:50 | Лаб. | ЛР №24. Восстановление данных и итоговый практикум |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 15.12 | Вт | 12:30–14:05 | Лекция | Л.15. Распределённые БД и двухфазная фиксация |
| Дата | День | Время | Тип | Тема | Открыть |
|---|---|---|---|---|---|
| 15.12 | Вт | 14:15–15:50 | Лекция | Л.16. Хранилища данных и подготовка к экзамену |
Отчёт: скриншоты + скрипт lab01_FIO.sql (ФИО латиницей).
Цель: впервые открыть SQL Server Management Studio (SSMS), подключиться к серверу в классе, разобраться с системными и пользовательскими базами, создать UniversityDB.
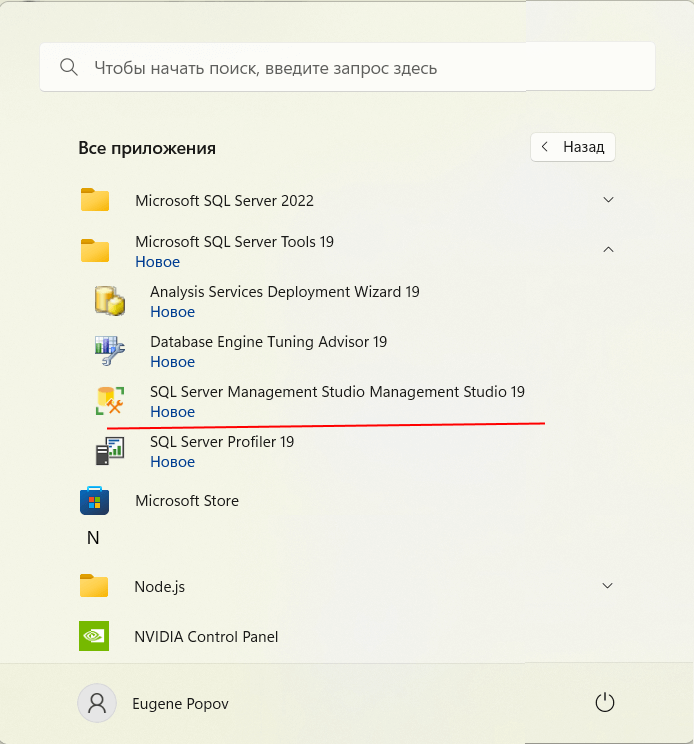
SQL Server Management Studio (SSMS) в меню Пуск — Microsoft SQL Server Tools.
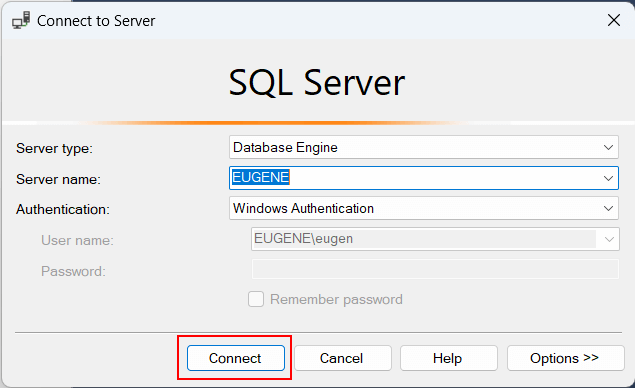
(local), .\SQLEXPRESS, ИМЯ-ПК\SQLEXPRESS).
Рисунок 1. Окно Connect to Server в SSMS.
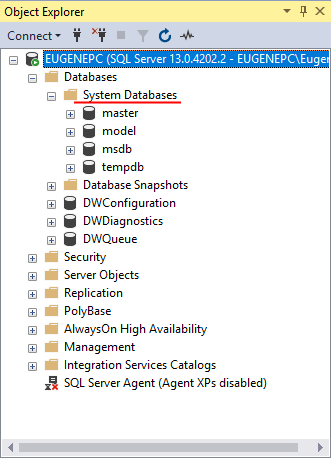
master, model, msdb, tempdb.master и tempdb.UniversityDB или базы других групп.
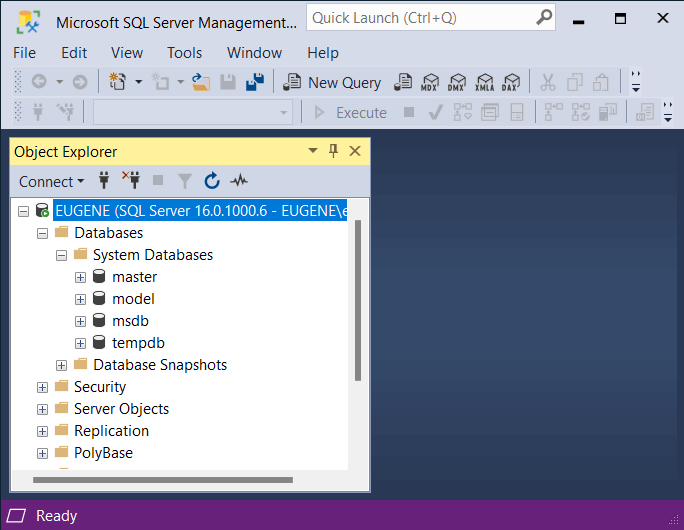
Рисунок 2. Узел System Databases в Object Explorer (скриншот SSMS).
Если база UniversityDB уже есть от прошлой попытки — согласуйте с преподавателем: использовать её или создать UniversityDB_Фамилия.
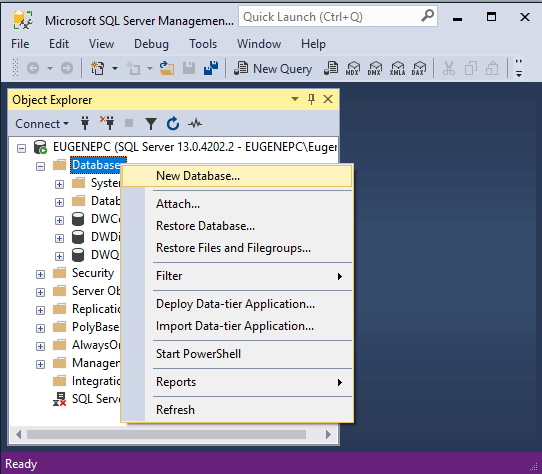
UniversityDB, OK.UniversityDB появилась.UniversityDB — Properties — вкладка Files: запишите путь к файлам .mdf и .ldf.
Создание базы: New Database… или CREATE DATABASE.
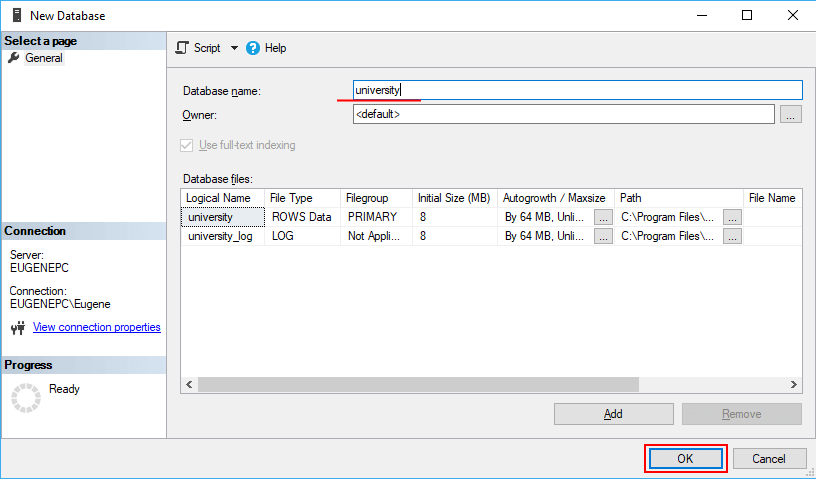
Рисунок 3. Свойства базы — путь к файлам .mdf и .ldf (вкладка Files).
UniversityDB.lab01_FIO.sql (ФИО латиницей).На всех лабораторных имя файла: labNN_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab01_IvanovII.sql.
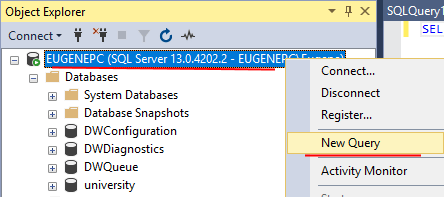
Окно New Query, выбор базы, команды SELECT.
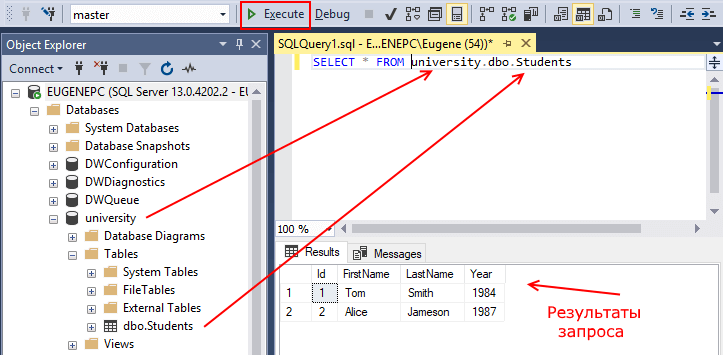
Рисунок 4. Результат выполнения запроса в панели Results.
lab01_FIO.sql (ФИО латиницей), но после CREATE DATABASE?Отчёт: скрипт lab02_FIO.sql (ФИО латиницей) + скриншоты результатов запросов.
Цель: в уже созданной на ЛР №1 пустой базе UniversityDB создать таблицы учебного эталона, загрузить данные и выполнить первые запросы SELECT.
UniversityDB → Tables. Список пользовательских таблиц должен быть пуст (или только системные).UniversityDB, выполните:Если базы нет — вернитесь к ЛР №1 или выполните CREATE DATABASE UniversityDB;.
Готовые команды CREATE TABLE и INSERT — на странице Приложение: БД и скрипты, раздел «Сборка базы по шагам». Там же объяснено, что такое SQL-скрипт и зачем он разбит на блоки.
На этой лабораторной вы не скачиваете файл — копируете блоки в окно запроса и сохраняете свою версию как lab02_FIO.sql (ФИО латиницей).
| Блок в приложении | Нужен на ЛР №2? | Что делает |
|---|---|---|
| 1. База данных | частично | Достаточно USE UniversityDB; — база уже есть |
| 2. Очистка таблиц | нет* | Только если таблицы уже создавали и нужно начать заново |
| 3. UNIVERSITY, SUBJECT | да | Справочники без внешних ключей — создаются первыми |
| 4. STUDENT, LECTURER | да | Строки ссылаются на вуз через UNIVERSITY_ID |
| 5. EXAM_MARKS, SUBJ_LECT, ORG_UNIT | да | Оценки и связи; на FK ссылаются на таблицы из блоков 3–4 |
| 6. INSERT | да | Эталонные данные — порядок 6.1 → 6.7, как в приложении |
* Если на прошлой попытке таблицы уже есть — выполните блок 2, затем блоки 3–6 заново.
UniversityDB.UniversityDB → Tables должны появиться семь таблиц.dbo.STUDENT → Design — видны столбцы STUDENT_ID, UNIVERSITY_ID, значок ключа у PK и FK.CREATE TABLE завершился ошибкой «foreign key» — вы, скорее всего, перепутали порядок блоков. Сначала родитель (UNIVERSITY), потом дочерние таблицы.Вставляйте блоки 6.1 → 6.7 по порядку из приложения (сначала вузы и предметы, в конце — подразделения). Можно выполнить весь блок 6 целиком или по частям — главное не нарушать порядок таблиц.
Контрольная проверка:
В ответе должно быть 19 студентов и 8 вузов. Сохраните скриншот результата для отчёта.
SELECT читает данные из таблиц; он ничего не меняет. Выполните запросы ниже по очереди, результаты — в отчёт.
Звёздочка * означает «все столбцы строки»:
В результате — 8 строк, столбцы UNIVERSITY_ID, UNIVERSITY_NAME, RATING, CITY.
Список столбцов через запятую — это проекция (выбор нужных полей):
Условие WHERE отбирает строки. Номер 10 — это ВГУ в эталонных данных:
В списке столбцов сначала NAME (имя), затем SURNAME (фамилия) — как требуется в задании.
Агрегатная функция COUNT(*) считает строки. Для эталона ответ снова 19.
Окно New Query: сверху выбрана база UniversityDB, ниже — текст SQL.
Результат SELECT — на вкладке Results.
lab02_FIO.sql (ФИО латиницей): команды USE, все CREATE TABLE, все INSERT и все SELECT из этой работы.-- ЛР №2, IvanovII, группа ВО-ИСИТ-31 (подставьте свои фамилию и инициалы латиницей).COUNT(*), один из запросов из §4.CHECK (стипендия ≥ 0, курс 1–6, оценка 2–5). Выполните заведомо неверный INSERT, например студента с KURS = 9, и прочитайте текст ошибки.UNIVERSITY_ID = 999. СУБД должна отклонить строку — нет такого вуза, сработал внешний ключ.dbo.EXAM_MARKS и найдите студента без оценок (STUDENT_ID = 19). Эта строка специально нужна для заданий с IS NULL на следующих лабораторных.UniversityDB после ЛР №1 отличается от той же базы после этой работы?UNIVERSITY создают раньше, чем STUDENT?SELECT * FROM UNIVERSITY и чем он отличается от SELECT UNIVERSITY_NAME, CITY FROM UNIVERSITY?INSERT студента с несуществующим UNIVERSITY_ID?lab02_FIO.sql (ФИО латиницей), если база уже создана на сервере?Отчёт: скрипт lab03_FIO.sql (ФИО латиницей) + скриншоты ошибок ограничений.
Цель: в той же UniversityDB, что и на ЛР №2, добавить нормализованные таблицы (группы и учебная библиотека вуза) с ограничениями PRIMARY KEY, UNIQUE, CHECK, FOREIGN KEY, загрузить данные и убедиться, что СУБД отклоняет неверные строки.
Связь с лекцией 3: декомпозиция «широкой» таблицы на сущности — как UNIVERSITY + STUDENT на ЛР №2 и как LIB_AUTHOR → LIB_BOOK → LIB_COPY сегодня. Отдельную базу данных на курсе не создаём.
UniversityDB после ЛР №2 (семь таблиц: UNIVERSITY, STUDENT, …).UniversityDB. Весь SQL ниже выполняйте только в ней.DROP DATABASE UniversityDB и не пересоздавайте таблицы ЛР №2 — только CREATE TABLE для новых имён ниже. Если ЛР №3 уже сдавалась, перед повтором удалите свои таблицы: DROP TABLE для LIB_COPY, LIB_BOOK, LIB_AUTHOR, ACADEMIC_GROUP (в таком порядке).На ЛР №1 вы создавали контейнер базы; сегодня дополняем уже существующую схему — так устроен весь курс: одна UniversityDB от CREATE TABLE до курсовой.
В current_database должно быть UniversityDB. Число таблиц до работы — обычно 7 (после шага 2 станет 11).
Сначала справочник групп (староста хранится один раз — см. лекцию 3 §4.3), затем цепочка библиотеки: автор → книга → экземпляр. Создавайте таблицы в указанном порядке.
| Таблица | Назначение | Ключевые ограничения |
|---|---|---|
ACADEMIC_GROUP | Учебные группы | GROUP_ID — PK; код группы; фамилия старосты |
LIB_AUTHOR | Авторы учебников/худ. лит. | AUTHOR_ID — PK |
LIB_BOOK | Книги (издания) | BOOK_ID — PK; ISBN — UNIQUE; PUB_YEAR — CHECK; FK на автора |
LIB_COPY | Экземпляры в библиотеке вуза | COPY_ID — PK; инв. номер — UNIQUE; STATUS — CHECK; FK на книгу + CASCADE |
PUB_YEAR — год издания; CHECK не допускает «1300» и будущие годы.
ON DELETE CASCADE: при удалении книги СУБД удалит все её экземпляры. STATUS: in — на полке, out — выдан читателю.
Object Explorer (F5): под UniversityDB → Tables — четыре новые таблицы рядом с STUDENT, EXAM_MARKS и др.
Сначала группы и авторы, затем книги, затем экземпляры — как при загрузке UniversityDB на ЛР №2.
Можете добавить свои строки (минимум 3–5 в каждой таблице). Проверка:
Выполните команды ниже по одной. Каждая должна завершиться ошибкой — это ожидаемый результат. Сохраните текст ошибки или скриншот для отчёта.
Нарушение UNIQUE на ISBN.
Нарушение CHECK на PUB_YEAR.
Нарушение CHECK на STATUS — допустимы только in и out.
Нарушение внешнего ключа — автора с AUTHOR_ID = 999 нет.
Кратко ответьте в комментарии в lab03_FIO.sql или в сопроводительном тексте:
LIB_AUTHOR, а не в каждой строке LIB_COPY; староста в ACADEMIC_GROUP, а не в каждой «широкой» строке с оценкой)Ожидаемый вывод: схема в 1НФ и 3НФ; разделение убирает аномалии обновления (смена фамилии автора — одна строка в LIB_AUTHOR).
lab03_FIO.sql (ФИО латиницей): USE UniversityDB, все CREATE TABLE, все успешные INSERT, контрольные SELECT COUNT.INSERT из §4 можно оставить в файле закомментированными (-- в начале строки) с пометкой «ожидаемая ошибка».-- ЛР №3, IvanovII, группа ВО-ИСИТ-31.UniversityDB, а не создают новую базу на каждую тему?LIB_BOOK создают после LIB_AUTHOR, а LIB_COPY — после LIB_BOOK?PRIMARY KEY отличается от UNIQUE на примере ISBN и BOOK_ID?ON DELETE CASCADE при удалении строки из LIB_BOOK?LIB_AUTHOR?Отчёт: скрипт lab04_FIO.sql (ФИО латиницей) + скриншоты из §1–5.
Цель: изменить существующую схему UniversityDB командами ALTER TABLE, добавить индексы, поработать с пакетами GO и убедиться, что ограничения FK и UNIQUE работают.
Связь с лекцией 4: схема живёт на общем сервере; ваш ALTER TABLE видят все сеансы. Внешние ключи с ЛР №2 защищают ссылки; сегодня добавляете столбец и индексы без пересоздания таблиц.
UniversityDB → Tables — как минимум семь таблиц после ЛР №2 (после ЛР №3 — ещё ACADEMIC_GROUP и LIB_*).UniversityDB, выполните контроль:Ожидается: 19 студентов и непустая таблица оценок. Если база пуста — повторите ЛР №2 (блоки приложения 3–6).
DROP DATABASE и не трогайте чужие базы на общем сервере.
Object Explorer: под UniversityDB → Tables — STUDENT, UNIVERSITY, …
На ЛР №2 таблицы создавали через CREATE TABLE. В живой системе схему чаще дополняют — так деканат добавляет поле «email» без пересоздания таблицы и без потери 19 строк.
dbo.STUDENT → Design — в списке столбцов появился EMAIL, тип varchar(100), Allow Nulls = да.student<STUDENT_ID>@edu.local:Конкретный запрос SELECT и ожидаемый фрагмент результата:
| STUDENT_ID | SURNAME | |
|---|---|---|
| 1 | … | student1@edu.local |
| 2 | … | student2@edu.local |
| … | … | … |
Фамилии возьмутся из вашего эталона; важны столбец EMAIL и шаблон адреса. Сделайте скриншот вкладки Results.
Окно New Query: сверху выбрана UniversityDB, ниже — ALTER и UPDATE.
Результат SELECT TOP 5 … EMAIL — приложите к отчёту.
UNIQUE запрещает два одинаковых значения в столбце (кроме NULL — в SQL Server несколько NULL в UNIQUE допустимы, но у вас все EMAIL заполнены).
Теперь намеренно нарушите правило — скопируйте адрес студента 1 студенту 2:
Ожидаемо: выполнение прервётся, на вкладке Messages текст вроде:
Сохраните скриншот вкладки Messages — это доказательство работы ограничения. Верните уникальные значения:
Если бы вы добавляли столбец UNIVERSITY_ID вместо EMAIL, FK не дал бы записать несуществующий вуз. Проверка (ожидается ошибка):
Индекс — отдельная структура для быстрого поиска по столбцу. На ЛР №5–6 вы часто будете писать WHERE CITY = … и WHERE UNIVERSITY_ID = … AND KURS = … — под такие фильтры индексы уместны.
Clustered индекс один на таблицу (обычно PK); nonclustered — дополнительные «указатели» к строкам.
В результате должны быть как минимум:
| index_name | type_desc | is_unique | Комментарий |
|---|---|---|---|
| PK__STUDENT… | CLUSTERED | 1 | первичный ключ |
| UQ_STUDENT_EMAIL | NONCLUSTERED | 1 | ваше UNIQUE |
| IX_STUDENT_CITY | NONCLUSTERED | 0 | создали в §3 |
| IX_STUDENT_UNIV_KURS | NONCLUSTERED | 0 | составной индекс |
Точное имя PK может отличаться — смотрите столбец index_name.
GO — не команда T-SQL, а разделитель пакетов в SSMS. Переменная, объявленная в одном пакете, не видна в следующем.
Ожидаемый результат второго пакета: students = 19.
Эксперимент: уберите оба GO и выполните скрипт целиком. Вторая строка DECLARE @cnt в том же пакете даст ошибку «имя переменной уже объявлено» или конфликт с первым пакетом — зафиксируйте текст ошибки в отчёте.
Cannot find object STUDENT — выполните USE UniversityDB;. Если столбец EMAIL уже добавлен — пропустите §1 или согласуйтесь с преподавателем. Повторный CREATE INDEX даст ошибку — индекс уже есть.lab04_FIO.sql (ФИО латиницей): USE, все ALTER, UPDATE, CREATE INDEX, SELECT из sys.indexes, скрипт с GO.-- ЛР №4, IvanovII, группа ВО-ИСИТ-31 (подставьте свои фамилию и инициалы латиницей).EMAIL и индексы для ЛР №5+ или удалить в конце скрипта:Имя файла отчёта: lab04_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab04_IvanovII.sql.
EXEC sp_helpindex 'dbo.STUDENT'; — сравните вывод с sys.indexes.IF NOT EXISTS (на курсе достаточно комментария).ALTER TABLE ADD безопаснее, чем «удалить STUDENT и создать заново».ALTER TABLE ADD отличается от повторного CREATE TABLE STUDENT?GO?sys.indexes отличить clustered и nonclustered индекс?Отчёт: скрипт lab05_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: выполнить выборку с проекцией (список столбцов) и селекцией (WHERE): сравнение, AND/OR/NOT, IN, BETWEEN, LIKE, IS NULL на UniversityDB.
Связь с лекцией 2: вы уже делали простые SELECT на ЛР №2; здесь — систематическая работа с фильтрами. Справочник таблиц и эталонные данные — в приложении.
UniversityDB.EMAIL — он не мешает; все запросы ниже работают и без него.Ожидается: 19 студентов, 24 строки в EXAM_MARKS, 8 предметов в SUBJECT (см. приложение).
Перед работой убедитесь, что в списке баз выбрана UniversityDB.
Проекция — какие столбцы показать. Селекция — какие строки отобрать (WHERE, §2–4).
Ожидается 8 строк, столбцы SUBJ_ID, SUBJ_NAME, HOUR, SEMESTER.
SUBJ_ID = 10)В эталоне — несколько строк (оценки разных студентов). В комментарии к скрипту укажите -- rows: N.
Ожидается 19 строк. Звёздочка * здесь не нужна — вы явно перечисляете столбцы отчёта.
Выполняйте запросы по одному. После каждого — запишите число строк (rows в углу Results или SELECT COUNT(*) … с тем же WHERE).
Ожидается 1 строка — «История» (SUBJ_ID = 56).
Ожидается 4 строки (56, 72, 56, 56 часов в эталоне).
Ожидается 6 вузов (рейтинг 410, 450, 470, 580, 650, 700).
Пример результата с фильтром — приложите один такой скриншот к отчёту.
Буква N перед строкой — Unicode для кириллицы.
Без скобок AND связывал бы только KURS = 2 со стипендией — логика изменилась бы.
% — любое продолжение. Укажите в комментарии, сколько строк вернулось.
Ожидается 1 строка — STUDENT_ID = 19 (специально для этой проверки).
Сохраните скриншот: сравнение «0 строк» и «1 строка» — хороший фрагмент отчёта.
| Ошибка | Что проверить |
|---|---|
| 0 строк там, где ждали данные | Выбрана ли UniversityDB; нет ли опечатки в N'Воронеж' |
CITY = NULL | Только IS NULL / IS NOT NULL |
| Фильтр по SEMESTER в STUDENT | Семестр — столбец таблицы SUBJECT, не студента |
Забыли dbo. | На учебном сервере лучше явно: dbo.STUDENT |
lab05_FIO.sql (ФИО латиницей).-- ЛР №5, IvanovII, группа ВО-ИСИТ-31 (подставьте свои фамилию и инициалы латиницей).-- rows: N с числом строк результата.= NULL и IS NULL из §4.3.Имя файла отчёта: lab05_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab05_IvanovII.sql.
SELECT * FROM dbo.STUDENT WHERE NOT (KURS < 3); — сравните с KURS >= 3.UNIVERSITY_ID = 10) с стипендией выше средней по этому вузу (подсказка: подзапрос — ЛР №9).SELECT не меняет данные и не требует ROLLBACK (в отличие от ЛР №6).SELECT?SEMESTER относится к таблице SUBJECT, а не STUDENT?LIKE N'С%' и зачем буква N?IS NULL отличается от = NULL?lab05_FIO.sql (ФИО латиницей), если результат виден на экране?Отчёт: скрипт lab06_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: изменять данные (DML), сортировать выборку, использовать TOP и DISTINCT; безопасно экспериментировать в транзакции с ROLLBACK (лекция 5).
Связь с лекцией 5–6: на общем сервере незафиксированные UPDATE/DELETE видят другие сеансы — поэтому учебные изменения только с откатом.
UPDATE, INSERT и DELETE ниже выполняйте внутри BEGIN TRAN … ROLLBACK. Не нажимайте COMMIT, пока не согласовали с преподавателем.Ожидается 19 студентов. Запишите число оценок — после всех ROLLBACK оно должно совпасть.
ORDER BY сортирует результат; TOP n ограничивает число строк (аналог LIMIT в других СУБД). DISTINCT убирает дубликаты в выборке.
Вверху списка — студенты с наибольшей стипендией. Скриншот для отчёта.
Ровно 5 строк (если в таблице ≥ 5 студентов).
В первом запросе — уникальные оценки (2–5); во втором — уникальные пары «курс + город».
Результат TOP 5 … ORDER BY STIPEND DESC — приложите к отчёту.
Сначала «пробные» строки — затем откат. Порядок: родитель UNIVERSITY, потом дочерний STUDENT (FK).
INSERT … SELECT вставляет строку, вычисленную запросом (здесь — рейтинг выше текущего максимума).
Перед изменением — SELECT с тем же WHERE; после UPDATE — повторный SELECT; в конце — ROLLBACK.
После ROLLBACK у студента 15 снова должен быть исходный UNIVERSITY_ID из эталона.
После отката последний COUNT совпадает с первым — двойки (если были) на месте.
Нельзя удалить вуз, пока на него ссылаются студенты. Сначала проверьте ошибку:
Правильный порядок внутри транзакции: сначала DELETE студентов, потом вуза.
| Ошибка | Что делать |
|---|---|
| Случайный COMMIT | На учебном сервере — только ROLLBACK; пересоздайте эталон с преподавателем |
| UPDATE без WHERE | Сначала SELECT с тем же условием — убедитесь, что трогаете нужные строки |
| DELETE родителя раньше ребёнка | Сначала дочерние строки или CASCADE (если задан) |
| Забыли ROLLBACK | SELECT @@TRANCOUNT; — если > 0, выполните ROLLBACK |
lab06_FIO.sql (ФИО латиницей).-- ЛР №6, IvanovII, группа ВО-ИСИТ-31.SELECT COUNT(*) FROM dbo.STUDENT; = 19.Имя файла отчёта: lab06_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab06_IvanovII.sql.
SELECT TOP 5 PERCENT STIPEND, … ORDER BY STIPEND DESC; — чем отличается от TOP 5?UPDATE с заведомо неверным CHECK (KURS = 9) внутри TRY/CATCH (ЛР №16).ORDER BY пишут после WHERE?ROLLBACK после демонстрационного UPDATE на общем сервере?INSERT … SELECT отличается от INSERT … VALUES?DELETE вуза без удаления студентов вызывает ошибку FK?Отчёт: скрипт lab07_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: использовать COUNT, SUM, AVG, MIN, MAX; понять, как NULL влияет на агрегаты; сверить ответы с эталоном из приложения.
Связь с курсом: на лекции 2 вы делали простые SELECT; здесь одна строка результата суммирует много строк таблицы. На ЛР №8 добавится GROUP BY — группы вместо «всей таблицы сразу».
Напоминание: все агрегаты, кроме COUNT(*), игнорируют строки, где аргумент равен NULL.
Ожидается: 19 студентов, 24 оценки, 8 предметов. Если числа другие — восстановите эталон (ЛР №2, блок 6 приложения).
COUNT(*) считает строки. COUNT(столбец) не учитывает NULL в этом столбце. COUNT(DISTINCT …) — число различных значений (NULL не входит).
Ожидается: 19, 18, 8. У студента STUDENT_ID = 19 поле CITY специально NULL — поэтому COUNT(CITY) на 1 меньше, чем COUNT(*).
В комментарии к скрипту запишите: -- all_rows: 19; with_city: 18; distinct_cities: 8.
Ожидается: min_st = 0, max_st = 250, avg_st ≈ 122.89 (среднее по всем 19, включая нулевые стипендии). Во втором запросе среднее только по студентам с STIPEND > 0 — ≈ 155.67 (15 строк).
Обратите внимание: нули в данных — не NULL; они участвуют в AVG первого запроса и занижают среднее.
Выполняйте запросы по одному; после каждого сверяйте результат с эталоном.
Ожидается: total_hours = 382 (сумма часов восьми предметов); min_rating = 320 (БГУ), max_rating = 700 (МГУ).
Ожидается: avg_mark ≈ 4.08; 9 пятёрок; 1 двойка; первая дата 2026-01-15, последняя 2026-06-12.
CAST(MARK AS FLOAT) нужен, чтобы среднее было дробным, а не целым от деления типа INT.
Пример вкладки Results для блока §3 — одна строка с несколькими агрегатами. Сделайте скриншот для отчёта.
В эталоне у всех 24 строк поле MARK заполнено — оба счётчика дают 24, разница 0. Это нормально: NULL в оценках зарезервирован для других заданий; здесь вы фиксируете, что COUNT(MARK) и COUNT(*) совпали.
Для строк с NULL смотрите §1: COUNT(CITY) vs COUNT(*) у STUDENT.
lab07_FIO.sql (ФИО латиницей).-- ЛР №7, IvanovII, группа ВО-ИСИТ-31.AVG и CAST.Имя файла отчёта: lab07_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab07_IvanovII.sql.
SELECT COUNT(*), COUNT(STIPEND) FROM dbo.STUDENT; — совпадут ли счётчики? Почему?SELECT AVG(CAST(STIPEND AS FLOAT)) FROM dbo.STUDENT WHERE KURS = 1; — посчитайте вручную для первого курса (подготовка к GROUP BY на ЛР №8).AVG(STIPEND) по всей таблице и среднее «только по получающим стипендию»?COUNT(CITY) меньше COUNT(*) у STUDENT?AVG(STIPEND) по всей таблице отличается от AVG при STIPEND > 0?CAST(MARK AS FLOAT) перед AVG?COUNT(MARK), если в столбце есть NULL?MIN/MAX по EXAM_DATE вы получили и что это означает для учебного семестра?Отчёт: скрипт lab08_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: группировать строки (GROUP BY), отбирать группы через HAVING, строить итоги GROUP BY ROLLUP в SQL Server.
Связь с ЛР №7: там агрегаты считали по всей таблице; здесь — отдельно по каждому курсу, городу, предмету. Справочник эталона — в приложении.
Правило SQL: каждый столбец в SELECT должен быть либо в GROUP BY, либо внутри агрегатной функции (COUNT, AVG, …).
Ожидается 19 студентов. Если база пуста — повторите ЛР №2.
GROUP BY делит строки на группы с одинаковым значением столбца; агрегат считается внутри каждой группы.
Ожидается 5 строк (курсы 1–5). Пример значений: курс 1 — 6 студентов, средняя стипендия 135.00; курс 2 — 4 студента, 167.50; курс 3 — 4, 96.25; курс 4 — 3, 120.00; курс 5 — 2, 55.00.
Групп с заполненным городом — 8; отдельная группа с CITY IS NULL (студент 19) — 1 строка. Чаще всего встречаются Воронеж и Москва (по 4 студента).
Ожидается 8 групп (вузы 10, 11, 12, 14, 15, 18, 22, 32). Например: UNIVERSITY_ID = 10 — 5 студентов, средняя стипендия ≈ 95.00; 22 (МГУ) — 4 студента, ≈ 102.50.
Результат GROUP BY KURS — несколько строк вместо одной сводки с ЛР №7.
Ожидается 7 предметов с оценками. Примеры: SUBJ_ID = 10 — 8 экзаменов, средний ≈ 4.00; 43 — 2 экзамена, средний 5.00; 22 — 4 экзамена, средний 3.50.
WHERE отбирает строки до группировки; HAVING — группы после агрегации (можно использовать условие на COUNT(*), AVG, …).
Ожидается 3 строки: курсы 1 (6), 2 (4), 3 (4). Курсы 4 и 5 отсеялись — в группе ≤ 3 студента.
Ожидается 6 предметов: 10, 18, 31, 43, 56, 94. Предмет 22 (средний 3.50) в список не попадает.
Сначала отбрасываются нулевые стипендии, затем считается среднее по оставшимся в группе. Пример: курс 1 — среднее ≈ 162.00 (5 студентов с ненулевой стипендией), курс 4 — 180.00 (студент 6 с нулём не участвует).
Если написать HAVING AVG(STIPEND) > 0 вместо WHERE STIPEND > 0, нули всё равно войдут в расчёт среднего внутри группы — результат будет другим. Это частая ошибка на защите.
ROLLUP добавляет строку с KURS IS NULL — итог по всей таблице: cnt = 19, avg_st ≈ 122.89 (как на ЛР №7 без группировки). Строки с числом в KURS — группы по курсам из §1.1.
lab08_FIO.sql (ФИО латиницей).-- ЛР №8, IvanovII, группа ВО-ИСИТ-31.GROUP BY KURS; HAVING COUNT(*) > 3; ROLLUP с итоговой строкой NULL.Имя файла отчёта: lab08_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab08_IvanovII.sql.
GROUP BY KURS, CITY — сколько групп получится? Сравните с группировкой только по KURS.SELECT KURS, SURNAME, COUNT(*) FROM STUDENT GROUP BY KURS вызывает ошибку?WITH ROLLUP к запросу §3.2 — что изменится в результате?Отчёт: скрипт lab09_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: писать скалярные подзапросы, использовать IN и NOT IN; понять, почему NOT IN опасен при NULL в подзапросе.
Связь с ЛР №8: там вы считали агрегаты с GROUP BY; здесь тот же MAX/AVG спрятан внутри WHERE — подзапрос возвращает одно значение для сравнения с каждой строкой внешнего запроса.
Ожидается 19 студентов.
Скалярный подзапрос возвращает одно значение (одну строку, один столбец). Его ставят в WHERE после =, >, < и т.д. Если вернётся больше одной строки — ошибка.
Ожидается 1 строка: Морозова, стипендия 250 (STUDENT_ID = 7).
Средняя по ненулевым ≈ 155.67. Ожидается 7 строк (Сидорова, Козлова, Морозова, Соколова, Зайцева, Лебедева, Крылова).
Средний рейтинг ≈ 496.25. Ожидается 3 вуза: НГУ (580), СПбГУ (650), МГУ (700).
Результат §1.1 — одна строка с максимальной стипендией.
IN (подзапрос) проверяет, входит ли значение во множество строк подзапроса. Эквивалентно нескольким OR, но короче и читабельнее.
В эталоне в Москве только МГУ (UNIVERSITY_ID = 22). Ожидается 4 студента (Сидорова, Сидоров, Кузнецов, Лебедева).
Предмет SUBJ_ID = 10 (Информатика). Ожидается 8 строк в EXAM_MARKS по этому предмету.
Тот же результат можно получить через JOIN — на ЛР №11 сравните оба стиля.
NOT IN исключает строки, попадающие в список подзапроса. Важно: если подзапрос вернёт хотя бы один NULL, результат внешнего запроса может стать пустым (логика трёхзначная). Поэтому в подзапросе часто пишут WHERE столбец IS NOT NULL.
В эталоне студенты есть в каждом из 8 вузов — результат 0 строк. Это нормально: запишите в отчёте «пустой результат — все вузы представлены».
Ожидается 1 строка: Медведев (STUDENT_ID = 19) — специально для заданий с NOT EXISTS на ЛР №10.
Ожидается 1 предмет: Физкультура (SUBJ_ID = 73).
WHERE SUBJ_ID IS NOT NULL и в EXAM_MARKS появится строка с SUBJ_ID = NULL, NOT IN может вернуть ноль строк для всех предметов. На ЛР №10 сравните с NOT EXISTS — он NULL не «ломает».lab09_FIO.sql (ФИО латиницей).-- ЛР №9, IvanovII, группа ВО-ИСИТ-31.-- rows: N и краткий вывод.Имя файла отчёта: lab09_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab09_IvanovII.sql.
JOIN с UNIVERSITY — совпали ли строки?WHERE STIPEND > ALL (SELECT STIPEND FROM STUDENT WHERE STIPEND > 0 AND STUDENT_ID <> 7) — кого оставит?SELECT * FROM STUDENT WHERE STUDENT_ID NOT IN (SELECT STUDENT_ID FROM EXAM_MARKS) без фильтра NULL может вести себя странно, если в EXAM_MARKS появится NULL в STUDENT_ID?WHERE должен вернуть ровно одно значение?IN с подзапросом отличается от JOIN?NOT IN опасен, если в подзапросе есть NULL?NOT IN?DISTINCT в подзапросе для UNIVERSITY_ID?Отчёт: скрипт lab10_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: писать коррелированные подзапросы; использовать EXISTS, NOT EXISTS, операторы ANY/ALL.
Связь с ЛР №9: там подзапрос был «сам по себе»; здесь внутренний запрос ссылается на строку внешнего (s1.UNIVERSITY_ID) — выполняется заново для каждой строки снаружи.
Внутренний SELECT использует столбец внешней строки (s1.UNIVERSITY_ID, s1.KURS). Для каждого студента заново считается средняя стипендия в его вузе на его курсе.
Ожидается 3 строки: Иванов (ВГУ, 1 курс — выше среднего по группе), Орлов (ЮФУ, 1 курс), Белкин (ВГУ, 3 курс). Нули в знаменателе не мешают — они входят в среднее по группе.
EXISTS (подзапрос) возвращает true, если подзапрос вернул хотя бы одну строку. Часто пишут SELECT 1 — важен факт наличия строк, а не их содержимое.
Ожидается 2 вуза: БГУ (студент 16) и МГУ (студент 10).
В эталоне у каждого вуза есть студенты — результат 0 строк (как NOT IN в ЛР №9).
Ожидается 8 студентов с хотя бы одной «5» (в эталоне — Иванов, Петров, Козлова, Волков, Кузнецов, Лебедева, Крылова и др.).
Ожидается 1 строка: Медведев (STUDENT_ID = 19) — тот же результат, что NOT IN на ЛР №9, но без ловушки NULL.
Результат §3 — один студент без оценок.
Строки, где оценка максимальна для своего предмета. Ожидается 12 строк (несколько «лучших» по предметам 10, 43, 56, 94 и т.д.). Если для предмета одна оценка — она тоже «максимальна».
Если подзапрос после ALL пуст (нет оценок по предмету), условие для внешней строки не выполняется — такие строки не попадут в результат.
lab10_FIO.sql (ФИО латиницей).-- ЛР №10, IvanovII, группа ВО-ИСИТ-31.-- rows: N и пояснение корреляции или EXISTS.Имя файла отчёта: lab10_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab10_IvanovII.sql.
LEFT JOIN … WHERE em.STUDENT_ID IS NULL.IN vs EXISTS для §2.1 — кратко в комментарии.WHERE STIPEND > ANY (SELECT …) — чем отличается от > ALL?s1.UNIVERSITY_ID?Отчёт: скрипт lab11_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: соединять таблицы через INNER JOIN и LEFT JOIN; строить отчёты по связям FK; считать агрегаты после JOIN.
Связь с ЛР №9–10: подзапрос с IN можно заменить JOIN — на этой работе учитесь читать и писать явные соединения. Схема FK — в приложении.
Нарисуйте цепочку: UNIVERSITY ← STUDENT → EXAM_MARKS → SUBJECT; отдельно SUBJ_LECT связывает SUBJECT и LECTURER. Условие соединения — равенство ключей FK.
INNER JOIN оставляет только строки, для которых есть пара в обеих таблицах. У каждого студента в эталоне есть вуз — потерь строк не будет.
Ожидается 19 строк — по числу студентов.
Ожидается 13 строк (студенты вузов в Москве, СПб, Новосибирске и т.д.; вузы ВГУ и ВГМУ в Воронеже отсеяны).
Ожидается 24 строки — все строки EXAM_MARKS с подставленными фамилиями и названиями предметов.
Ожидается 12 строк — по таблице SUBJ_LECT в приложении.
К отчёту приложите свой скриншот вкладки Results для запроса §2.1 (ожидается 24 строки: фамилия, предмет, оценка, дата).
LEFT JOIN сохраняет все строки левой таблицы; если справа нет пары — столбцы справа NULL.
Ожидается 19 строк с фамилиями (у каждого вуза есть студенты; «пустых» вузов нет).
В эталоне — 0 строк. Запишите в отчёте: «все 8 вузов представлены студентами».
Ожидается 1 строка: Медведев (STUDENT_ID = 19) — тот же результат, что NOT EXISTS на ЛР №10.
Ожидается 8 строк. Используйте COUNT(s.STUDENT_ID), а не COUNT(*) — иначе вуз без студентов дал бы 1 вместо 0 (в эталоне все счётчики ≥ 1).
Только студенты с оценками; у Медведева строки не будет. Число строк — 18 (19 − 1 без ведомости).
lab11_FIO.sql или приложите схему отдельно в PDF.-- ЛР №11, IvanovII, группа ВО-ИСИТ-31.Имя файла отчёта: lab11_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab11_IvanovII.sql.
IN (ЛР №9) — совпали ли строки?RIGHT JOIN отличается от LEFT JOIN (поменяли таблицы местами)?ON (декартово произведение).Отчёт: скрипт lab12_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: объединять результаты нескольких SELECT; понять разницу UNION и UNION ALL; применить множественные операции к эталону UniversityDB.
Связь с ЛР №11: JOIN соединяет таблицы в одном запросе; UNION складывает результаты двух запросов с одинаковым числом столбцов.
В эталоне: 19 студентов, 10 преподавателей, 24 строки EXAM_MARKS; у Медведева (STUDENT_ID=19) нет оценок.
Средний балл по студенту с названием вуза — закрепление ЛР №11.
Ожидается 19 строк; у Медведева avg_mark = NULL.
Ожидается 29 строк (19 студентов + 10 преподавателей).
INTERSECT — 7 городов (Воронеж, Москва, Новосибирск, Санкт-Петербург, Белгород, Томск, Ростов-на-Дону). EXCEPT — 1 строка: Курск (есть у студентов, нет среди городов вузов).
Повторите §2 с UNION вместо UNION ALL. В эталоне фамилии студентов и преподавателей не пересекаются — снова 29 строк. Запишите в отчёте: UNION удаляет дубликаты между двумя наборами; UNION ALL — нет.
Только предметы с не менее двух оценок. Ожидается до 5 строк — зафиксируйте фактическое число и значения avg_mark в комментарии -- rows: N.
lab12_FIO.sql.-- ЛР №12, IvanovII, группа ВО-ИСИТ-31.Имя файла отчёта: lab12_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab12_IvanovII.sql.
Отчёт: скрипт lab13_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: строковые и дата-функции T-SQL, ROUND, CAST на UniversityDB.
Первый запрос — 19 строк. LEN(SURNAME)=6 — 8 студентов: Петров, Козлова, Новиков, Сидоров, Волков, Павлов, Белкин, Крылова.
Ожидается 16 экзаменов в январе 2026 (все даты EXAM_MARKS в эталоне — 2026 год).
По каждому курсу — одна строка агрегата (курсы 1–4 в эталоне).
Ожидается 8 строк — по числу вузов.
lab13_FIO.sql.-- ЛР №13, IvanovII, группа ВО-ИСИТ-31.Имя файла отчёта: lab13_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab13_IvanovII.sql.
Отчёт: скрипт lab14_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: условные выражения и обработка NULL в SELECT; студент STUDENT_ID=19 (Медведев) с CITY IS NULL.
Ожидается 1 строка: STUDENT_ID=19, Медведев, CITY = NULL.
Ожидается 24 строки — все записи ведомости.
Ожидается 19 строк — по каждому студенту.
У Медведева в обоих запросах — не указан вместо NULL.
Во втором запросе Медведев с NULL — в конце списка.
Ожидается 4 строки — по числу категорий стипендии.
lab14_FIO.sql.-- ЛР №14, IvanovII, группа ВО-ИСИТ-31.Имя файла отчёта: lab14_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab14_IvanovII.sql.
Отчёт: скрипт lab15_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: объявление переменных DECLARE/SET, ветвление IF/ELSE, проверка IF EXISTS в T-SQL.
При @kurs = 3 ожидается 4 студента.
Результат PRINT — на вкладке Messages в SSMS.
Ожидается сообщение «Есть студенты без экзаменов» (Медведев, STUDENT_ID=19).
lab15_FIO.sql.-- ЛР №15, IvanovII, группа ВО-ИСИТ-31.Имя файла отчёта: lab15_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab15_IvanovII.sql.
Отчёт: скрипт lab16_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: цикл WHILE, обработка ошибок TRY/CATCH, транзакция с откатом.
Ожидается 10 строк — числа от 1 до 10.
Ожидается строка с err_num (нарушение FK) — без изменения данных.
Оценка 6 вне диапазона CHECK — попадание в CATCH, строка не вставляется.
При успехе стипендии студентов 1 и 3 не меняются в сумме; при ошибке — ROLLBACK.
lab16_FIO.sql.-- ЛР №16, IvanovII, группа ВО-ИСИТ-31.Имя файла отчёта: lab16_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab16_IvanovII.sql.
Отчёт: скрипт lab17_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: тип XML, методы .value() и .query(); связь с лекциями 9–10.
Ожидается 1 строка в UnivXml для univ_id=10 (ВГУ).
Ожидается название ВГУ и город Воронеж.
Во втором запросе — 2 строки (Иванов, Петров из XML).
Если права позволяют:
Иначе в отчёте опишите: индекс ускоряет XPath-запросы к большим документам.
lab17_FIO.sql.-- ЛР №17, IvanovII, группа ВО-ИСИТ-31.Имя файла отчёта: lab17_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab17_IvanovII.sql.
Отчёт: скрипт lab18_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: рекурсивный CTE по таблице ORG_UNIT в UniversityDB; сравнение adjacency list и nested sets.
В эталоне 10 строк в ORG_UNIT (иерархии ВГУ и МГУ).
От корня UNIT_ID=1 (ВГУ) ожидается 7 строк — всё поддерево вуза 10.
Столбец lvl — уровень вложенности (0 у ректората, 1 у факультетов и т.д.).
Кратко сравните adjacency list (PARENT_ID, как в ORG_UNIT) и nested sets (left/right): плюсы и минусы каждой модели.
lab18_FIO.sql.-- ЛР №18, IvanovII, группа ВО-ИСИТ-31.Имя файла отчёта: lab18_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab18_IvanovII.sql.
Отчёт: скриншоты Compass + lab19_FIO.pdf (ФИО латиницей).
Цель: документная модель в MongoDB Compass; сравнение с реляционной строкой dbo.STUDENT.
Стенд: MongoDB Compass на учебном ПК (или MongoDB Atlas по указанию преподавателя). SQL Server для сравнения — UniversityDB.
University и коллекцию students.USE UniversityDB; — данные для документов возьмите из STUDENT + UNIVERSITY.Вставьте минимум пять документов с полями _id, surname, name, kurs, вложенный объект university: { name, city }:
Данные можно взять из:
Ожидается 5 документов в коллекции students.
Зафиксируйте число документов при фильтре kurs: 3 — в эталоне SQL при KURS=3 четыре студента.
После deleteOne документ 99 отсутствует — приложите скриншот.
lab19_FIO.pdf: скриншоты Compass, примеры запросов.STUDENT+JOIN UNIVERSITY.Имя файла отчёта: lab19_FIO.pdf (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab19_IvanovII.pdf.
Отчёт: скрипт lab20_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: создать представления VIEW на UniversityDB, упростить доступ к JOIN и проверить чтение через представление.
Связь с лекцией 12: VIEW — сохранённый запрос с именем, а не копия таблицы.
VIEW содержит 19 строк — по числу студентов.
Во VIEW — 24 строки; фильтр MARK=5 — 9 пятёрок в эталоне.
Объясните в комментарии к скрипту: WITH SCHEMABINDING защищает определение VIEW от изменения базовых столбцов.
lab20_FIO.sql.-- ЛР №20, IvanovII, группа ВО-ИСИТ-31.v_StudentUniv и v_StudentMarks WHERE MARK=5.Имя файла отчёта: lab20_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab20_IvanovII.sql.
Отчёт: скрипт lab21_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: создать и вызвать хранимые процедуры на T-SQL, в том числе usp_StudentByKurs из лекции 12.
При @kurs = 3 ожидается 4 студента.
lab21_FIO.sql.-- ЛР №21, IvanovII, группа ВО-ИСИТ-31.Имя файла отчёта: lab21_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab21_IvanovII.sql.
Отчёт: скрипт lab22_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: создать AFTER-триггер аудита на EXAM_MARKS и INSTEAD OF INSERT на представление v_StudentUniv.
Измените оценку в транзакции с ROLLBACK и проверьте SELECT * FROM dbo.AuditLog; — после ROLLBACK записей аудита не останется.
Объясните в отчёте: VIEW с JOIN не всегда updatable — INSTEAD OF перенаправляет INSERT на базовые таблицы.
lab22_FIO.sql.-- ЛР №22, IvanovII, группа ВО-ИСИТ-31.Имя файла отчёта: lab22_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab22_IvanovII.sql.
Отчёт: скрипт lab23_FIO.sql (ФИО латиницей) + скриншоты результатов.
Цель: login, user, database role; выдать минимальные права на UniversityDB; связь с лекцией 14.
Подключитесь вторым окном SSMS как reader_test и попробуйте:
Ожидается отказ — нет INSERT на STUDENT (только SELECT через role_read).
После GRANT EXECUTE пользователь reader_test может вызвать процедуру без прямого SELECT на LECTURER.
lab23_FIO.sql.-- ЛР №23, IvanovII, группа ВО-ИСИТ-31.Имя файла отчёта: lab23_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab23_IvanovII.sql.
Отчёт: lab24_FIO.sql (ФИО латиницей) + защита.
Цель: резервное копирование и восстановление (лекции 13–14) + комплексный практикум по материалам семестра на UniversityDB.
UniversityDB в эталонном состоянии: 19 студентов, 24 оценки..bak на учебном сервере.Если нет прав — приложите скриншоты SSMS и текстовый план RESTORE.
Опишите цепочку FULL / DIFF / LOG backup и когда нужен STOPAT.
Выполните минимум восемь пунктов ниже; каждый — отдельный блок в lab24_FIO.sql с комментарием.
GROUP BY + HAVING (средний балл по предметам).EXISTS (студенты без оценок — ожидается Медведев).CREATE VIEW + SELECT из VIEW.usp_StudentByKurs с @kurs=3 — 4 строки.DROP TRIGGER в конце скрипта).CITY.GRANT/REVOKE или описание, если нет прав.ORG_UNIT от UNIT_ID=1 — 7 строк.dbo.UnivXml (если таблица ещё есть с ЛР №17).lab24_FIO.sql.-- ЛР №24, IvanovII, группа ВО-ИСИТ-31.Имя файла отчёта: lab24_FIO.sql (ФИО латиницей) — вместо FIO подставьте фамилию и инициалы латиницей, например lab24_IvanovII.sql.
UniversityDB_restore, а не поверх боевой базы?| № | Тема | Вид | Часы | Материал курса |
|---|---|---|---|---|
| Раздел 1. Основы баз данных и проектирование (нед. 1–3) | ||||
| 1 | Основные понятия баз данных и СУБД | Лек | 2 | Л.1 |
| 2 | SSMS: системные и учебные БД | Лаб | 2 | ЛР №1 |
| 3 | Реляционная модель. Функциональные зависимости | Лек | 2 | Л.2 |
| 4 | Таблицы и первый SELECT | Лаб | 2 | ЛР №2 |
| 5 | Нормализация. Аномалии обновления | Лек | 2 | Л.3 |
| 6 | DDL: CREATE, типы, ограничения | Лаб | 2 | ЛР №3 |
| 7 | FK, ALTER TABLE, индексы | Лаб | 2 | ЛР №4 |
| Раздел 2. SQL: выборка и изменение данных (нед. 4) | ||||
| 8 | Многопользовательские и распределённые БД | Лек | 2 | Л.4 |
| 9 | INSERT, SELECT, WHERE | Лаб | 2 | ЛР №5 |
| 10 | UPDATE, DELETE, ORDER BY | Лаб | 2 | ЛР №6 |
| Раздел 3. Транзакции и многопользовательский доступ (нед. 5–8) | ||||
| 11 | Транзакции. Свойства ACID | Лек | 2 | Л.5 |
| 12 | Агрегатные функции | Лаб | 2 | ЛР №7 |
| 13 | GROUP BY, HAVING, ROLLUP | Лаб | 2 | ЛР №8 |
| 14 | Аномалии параллельного доступа | Лек | 2 | Л.6 |
| 15 | Вложенные подзапросы | Лаб | 2 | ЛР №9 |
| 16 | Коррелированные подзапросы и EXISTS | Лаб | 2 | ЛР №10 |
| 17 | Уровни изоляции транзакций | Лек | 2 | Л.7 |
| 18 | INNER и OUTER JOIN | Лаб | 2 | ЛР №11 |
| 19 | UNION, EXCEPT, INTERSECT | Лаб | 2 | ЛР №12 |
| 20 | Блокировки, тупики, репликация | Лек | 2 | Л.8 |
| 21 | Функции строк, чисел, дат | Лаб | 2 | ЛР №13 |
| 22 | CASE, ISNULL, COALESCE | Лаб | 2 | ЛР №14 |
| Раздел 4. XML, иерархии и нереляционные модели (нед. 9–10) | ||||
| 23 | Структурированные и неструктурированные данные | Лек | 2 | Л.9 |
| 24 | Переменные и IF | Лаб | 2 | ЛР №15 |
| 25 | Циклы WHILE и TRY/CATCH | Лаб | 2 | ЛР №16 |
| 26 | Язык XML | Лек | 2 | Л.10 |
| 27 | XML в SQL Server | Лаб | 2 | ЛР №17 |
| 28 | Иерархические данные | Лаб | 2 | ЛР №18 |
| Раздел 5. Администрирование и программирование в СУБД (нед. 11–12) | ||||
| 29 | Администрирование и мониторинг СУБД | Лек | 2 | Л.11 |
| 30 | MongoDB — документная БД | Лаб | 2 | ЛР №19 |
| 31 | Представления VIEW | Лаб | 2 | ЛР №20 |
| 32 | Программирование в БД: процедуры, триггеры | Лек | 2 | Л.12 |
| 33 | Хранимые процедуры | Лаб | 2 | ЛР №21 |
| 34 | Триггеры DML и INSTEAD OF | Лаб | 2 | ЛР №22 |
| Раздел 6. Резервное копирование и защита данных (нед. 13–14) | ||||
| 35 | Резервное копирование | Лек | 2 | Л.13 |
| 36 | GRANT, REVOKE, роли | Лаб | 2 | ЛР №23 |
| 37 | Восстановление данных и защита | Лек | 2 | Л.14 |
| 38 | Восстановление данных и итоговый практикум | Лаб | 2 | ЛР №24 |
| Раздел 7. Распределённые БД и хранилища данных (нед. 15–16) | ||||
| 39 | Распределённые БД и двухфазная фиксация | Лек | 2 | Л.15 · курсовые №6, 21 |
| 40 | Хранилища данных и подготовка к экзамену | Лек | 2 | Л.16 · билеты |
| Раздел 8. Итоговая аттестация | ||||
| 41 | Экзамен по дисциплине «Управление данными» | ИКР | 2,3 | Экзамен · вопросы |
| Лекция | Тема | ЛР | На практике |
|---|---|---|---|
| Л.1 | Понятия БД, СУБД, SSMS | №1 | CREATE DATABASE, подключение |
| Л.2 | Реляционная модель, ФЗ | №2 | таблицы, INSERT, SELECT |
| Л.3 | Нормализация, ключи | №3–4 | DDL, FK, ALTER, индексы |
| Л.4 | Многопользовательский доступ | №5–6 | DML, WHERE, UPDATE, DELETE |
| Л.5 | ACID, транзакции | №7–8 | агрегаты, GROUP BY |
| Л.6 | Аномалии параллельного доступа | №9–10 | подзапросы, EXISTS |
| Л.7 | Уровни изоляции | №11–12 | JOIN, UNION |
| Л.8 | Блокировки, тупики, репликация | №13–14 | функции, CASE |
| Л.9 | Структурированные / неструктурированные данные | №15–16 | переменные, TRY/CATCH |
| Л.10 | XML, XSD | №17–18 | XML в SQL Server, CTE-иерархии |
| Л.11 | Администрирование, мониторинг | №19–20 | MongoDB, VIEW |
| Л.12 | Процедуры, триггеры, планы | №21–22 | процедуры, триггеры |
| Л.13 | Резервное копирование | №23 | GRANT, роли |
| Л.14 | Восстановление, защита данных | №24 | BACKUP/RESTORE + практикум |
| Л.15 | Распределённые БД, 2PC | — | теория · курсовые №6, 21 |
| Л.16 | OLAP, подготовка к экзамену | — | вопросы · билеты |
| Вид | Количество | Академ. часы |
|---|---|---|
| Лекции | 16 пар | 32 |
| Лабораторные | 24 пары | 48 |
| Итого контакт | 40 пар | 80 |
| Экзамен (ИКР) | 1 | 2,3 |
Kursovaya_FIO (или согласованное имя); не менее 5 таблиц с PRIMARY KEY, FOREIGN KEY, минимум два ограничения CHECK или UNIQUE; осмысленное наполнение (не «пустые таблицы»).SELECT с WHERE, JOIN, агрегаты с GROUP BY/HAVING, подзапрос или EXISTS; плюс один из элементов серверного программирования: VIEW, хранимая процедура или AFTER-триггер (аудит или бизнес-правило).BEGIN TRAN … COMMIT/ROLLBACK (операция из нескольких шагов) или демонстрация резервного копирования своей базы (BACKUP / описание RESTORE).kursovaya_FIO.sql (ФИО латиницей) + пояснительная записка со скриншотами SSMS (схема, примеры запросов, при наличии — план выполнения или права доступа).Свою тему (не из списка) можно предложить преподавателю, если она укладывается в минимум выше и не дублирует UniversityDB «одной таблицей Excel».
| № | Тема и содержание проекта |
|---|---|
| 1 | Интернет-магазин. Спроектировать БД: товары, категории, клиенты, заказы, строки заказа. Реализовать оформление заказа в транзакции; отчёты — топ товаров, сумма по клиентам; VIEW «активные заказы». |
| 2 | Частная клиника. Пациенты, врачи, приёмы, диагнозы, назначения. Связи M:N «врач — специализация»; CHECK на дату приёма; процедура «расписание врача на неделю». |
| 3 | Автосервис. Клиенты, автомобили, заказ-наряды, работы, запчасти. FK «авто → владелец»; агрегат «выручка по месяцам»; триггер аудита изменения стоимости наряда. |
| 4 | Гостиница. Номера, типы номеров, бронирования, гости, оплаты. Запрет пересечения броней (CHECK или триггер); JOIN «загрузка номеров»; резервная копия перед тестовым наполнением. |
| 5 | Публичная библиотека. Книги, авторы, экземпляры, читатели, выдачи. Нормализация «автор не дублируется в каждой выдаче»; EXISTS «книги на руках у читателя»; процедура выдачи/возврата. |
| 6 | Фитнес-клуб. Абонементы, типы, посещения, тренеры, групповые занятия. GROUP BY «популярность занятий»; транзакция продления абонемента; VIEW для ресепшена. |
| 7 | Ресторан / доставка. Меню, блюда, ингредиенты, заказы, курьеры. M:N «блюдо — ингредиент»; HAVING «блюда дороже среднего»; XML-описание акции (столбец XML, извлечение поля). |
| 8 | Агентство недвижимости. Объекты, типы, районы, клиенты, сделки, агенты. Иерархия районов (рекурсивный CTE); подзапрос «объекты без сделок»; индекс по цене + комментарий к плану запроса. |
| 9 | Ветеринарная клиника. Владельцы, питомцы, породы, приёмы, вакцинации. CHECK на вид животного; LEFT JOIN «питомцы без приёмов за год»; роли «ветеринар / регистратор» (GRANT на уровне учебного login). |
| 10 | Музыкальная школа. Ученики, преподаватели, инструменты, уроки, абонементы. Расписание без двойного бронирования кабинета; GROUP BY «часы по преподавателям»; процедура usp_LessonsByTeacher. |
| 11 | Фото-студия. Клиенты, пакеты услуг, брони слотов, фотографы, оборудование. Транзакция «бронь + предоплата»; VIEW «загрузка студии по дням»; миграция прайса из Excel (описать шаги загрузки). |
| 12 | Прокат велосипедов. Пункты проката, велосипеды, клиенты, аренды, штрафы. FK и CASCADE при списании велосипеда; отчёт «простой парка»; BACKUP после наполнения эталоном. |
| 13 | Кафе настольных игр. Игры, жанры, столы, брони, участники турниров. M:N «турнир — игрок»; EXISTS «игроки без турниров»; триггер запрета удаления игры с активными бронями. |
| 14 | Центр репетиторства. Предметы, репетиторы, ученики, занятия, оплаты. Нормализация «не хранить ФИО репетитора в каждой оплате»; JOIN «долги учеников»; процедура отчёта за период. |
| 15 | Цветочный магазин. Букеты, компоненты, поставщики, заказы, доставки. CHECK на сезонность/остаток; UNION «все контактные лица (клиенты + поставщики)»; VIEW для витрины заказов. |
| 16 | IT-Helpdesk. Пользователи, категории заявок, тикеты, комментарии, исполнители. Статусы и история (таблица аудита или триггер); GROUP BY «среднее время закрытия»; демонстрация блокировки при параллельном UPDATE статуса. |
| 17 | Садовое товарищество. Участки, владельцы, взносы, показания счётчиков, обращения. Иерархия «улица — участок»; агрегаты по задолженности; сравнение «плохая одна таблица» vs нормализованная схема в записке. |
| 18 | Приют для животных. Питомцы, породы, поступления, усыновления, волонтёры, пожертвования. NOT EXISTS «давно не усыновлённые»; транзакция «усыновление + закрытие карточки»; этичные тестовые данные без реальных ФИО. |
| 19 | Коворкинг. Помещения, рабочие места, тарифы, брони, резиденты. Рекурсивный CTE по зонам этажа; процедура поиска свободного места; RESTORE на копию Kursovaya_FIO_restore после ошибочного DELETE. |
| 20 | Кинотеатр. Залы, сеансы, фильмы, места, билеты, кассиры. Уникальность «место + сеанс»; JOIN «заполняемость сеансов»; VIEW для онлайн-расписания; индекс по дате сеанса. |
| 21 | Прачечная / химчистка. Клиенты, изделия, услуги, приёмы в работу, статусы, оплаты. CHECK на допустимый статус; GROUP BY «выручка по видам услуг»; сценарий ROLLBACK при ошибочном массовом UPDATE. |
| 22 | Каршеринг (локальный парк). Автомобили, тарифы, поездки, клиенты, штрафы, ТО. FK и даты; подзапрос «клиенты с поездками > N»; описание RPO/RTO для такой БД в записке. |
| 23 | Музей. Экспонаты, залы, эпохи, экскурсии, гиды, билеты. M:N «экскурсия — экспонат»; агрегат «посещаемость по залам»; хранение текста экспозиции в XML с выборкой XPath. |
| 24 | Спортивная секция. Секции, тренеры, спортсмены, соревнования, результаты, медосмотры. GROUP BY «медали по секциям»; процедура зачисления в секцию; GRANT «тренер видит только свою секцию» через VIEW и права. |
| 25 | Своя тема (по согласованию). Любая предметная область студента: от онлайн-курсов до складского учёта — при условии выполнения минимума из списка выше и защиты ER-схемы на консультации до сдачи. |
UniversityDB — единая учебная база курса: вузы, студенты, преподаватели, предметы, оценки; с ЛР №3 — группы (ACADEMIC_GROUP) и учебная библиотека (LIB_*). После лабораторных с изменением данных (DML, триггеры) базу можно восстановить, заново выполнив блоки ниже.
SQL-скрипт — это обычный текст с командами T-SQL: создание таблиц, вставка строк, запросы. В SSMS его набирают или вставляют в окно New Query и выполняют клавишей F5 (или кнопкой Execute). Сервер выполняет команды и сохраняет результат в файлах базы на диске — не в окне SSMS.
Эталонный скрипт UniversityDB собран для этого курса и лежит на этой странице — отдельного файла скачивать не нужно. Ниже он разбит на блоки с пояснениями. На ЛР №2 вы копируете блоки по порядку в SSMS и сохраняете свою копию в файл lab02_FIO.sql (ФИО латиницей) — это уже ваш рабочий файл, а не «чужой скрипт из ниоткуда».
UniversityDB.CREATE TABLE. Блок 6 — INSERT. Между частями с GO можно выполнять по очереди.UNIVERSITY 1—∞ STUDENT, UNIVERSITY 1—∞ LECTURER, UNIVERSITY 1—∞ ORG_UNIT.
SUBJECT 1—∞ EXAM_MARKS, STUDENT 1—∞ EXAM_MARKS.
LECTURER ∞—∞ SUBJECT через SUBJ_LECT.
ORG_UNIT.PARENT_ID ссылается на ORG_UNIT.UNIT_ID (иерархия).
Выполняйте блоки по порядку. Если база пустая после ЛР №1, блок 2 можно пропустить.
Создаёт базу UniversityDB, если её ещё нет, и переключает контекст на неё. На ЛР №1 вы уже делали то же командой CREATE DATABASE — здесь повтор для полного эталона.
Нужен только если таблицы уже создавали и хотите пересобрать схему с нуля. Удаление идёт от зависимых таблиц к независимым — иначе СУБД не даст удалить родительскую таблицу.
Таблицы, на которые ссылаются другие: список вузов и список предметов. Создаются первыми.
У каждой строки — ссылка UNIVERSITY_ID на справочник вузов (внешний ключ). Именно так устроена схема из лекции 2.
EXAM_MARKS — оценка студента по предмету. SUBJ_LECT — кто какой предмет ведёт. ORG_UNIT — иерархия кафедр (нужна на ЛР №18).
Строки вставляются в порядке зависимостей: сначала родители (UNIVERSITY, SUBJECT), потом дети. Иначе внешний ключ не найдёт ссылку и INSERT завершится ошибкой.
6.1. Вузы:
6.2. Предметы:
6.3. Студенты (19 строк; у id=19 город NULL — для заданий с IS NULL):
6.4. Преподаватели:
6.5. Оценки (24 строки; у студента 19 оценок нет — для NOT EXISTS и LEFT JOIN):
6.6. Кто какой предмет ведёт:
6.7. Подразделения вузов:
Проверка после блока 6: SELECT COUNT(*) FROM STUDENT; — должно быть 19. У студента с STUDENT_ID = 19 нет строк в EXAM_MARKS.
Те же строки, что в блоке 6, в удобном виде — можно сверить результат после INSERT.
На телефоне широкие таблицы прокручиваются пальцем влево и вправо.
| UNIVERSITY_ID | UNIVERSITY_NAME | RATING | CITY |
|---|---|---|---|
| 10 | ВГУ | 450 | Воронеж |
| 11 | НГУ | 580 | Новосибирск |
| 12 | СПбГУ | 650 | Санкт-Петербург |
| 14 | БГУ | 320 | Белгород |
| 15 | ТГУ | 390 | Томск |
| 18 | ВГМУ | 410 | Воронеж |
| 22 | МГУ | 700 | Москва |
| 32 | ЮФУ | 470 | Ростов-на-Дону |
| ID | Фамилия | Имя | Стип. | Курс | Город | Рождение | Вуз |
|---|---|---|---|---|---|---|---|
| 1 | Иванов | Иван | 150 | 1 | Воронеж | 2007-03-12 | 10 |
| 2 | Сидорова | Анна | 200 | 1 | Москва | 2007-07-01 | 22 |
| 3 | Петров | Пётр | 0 | 3 | Курск | 2005-11-20 | 10 |
| 4 | Козлова | Мария | 180 | 2 | Санкт-Петербург | 2006-04-15 | 12 |
| 5 | Новиков | Дмитрий | 120 | 2 | Новосибирск | 2006-09-03 | 11 |
| 6 | Сидоров | Вадим | 0 | 4 | Москва | 2004-01-28 | 22 |
| 7 | Морозова | Елена | 250 | 1 | Белгород | 2007-12-05 | 14 |
| 8 | Волков | Алексей | 140 | 3 | Томск | 2005-06-17 | 15 |
| 9 | Соколова | Ирина | 160 | 2 | Воронеж | 2006-02-22 | 18 |
| 10 | Кузнецов | Борис | 0 | 5 | Москва | 2003-08-09 | 22 |
| 11 | Орлов | Никита | 130 | 1 | Ростов-на-Дону | 2007-05-14 | 32 |
| 12 | Зайцева | Ольга | 170 | 4 | Воронеж | 2004-10-30 | 10 |
| 13 | Павлов | Андрей | 90 | 3 | Новосибирск | 2005-03-08 | 11 |
| 14 | Лебедева | Татьяна | 210 | 2 | Москва | 2006-12-19 | 22 |
| 15 | Котов | Павел | 0 | 1 | Курск | 2008-01-11 | 10 |
| 16 | Лукин | Артём | 110 | 5 | Белгород | 2003-04-25 | 14 |
| 17 | Белкин | Вадим | 155 | 3 | Воронеж | 2005-09-16 | 10 |
| 18 | Крылова | Светлана | 190 | 4 | Санкт-Петербург | 2004-07-07 | 12 |
| 19 | Медведев | Олег | 80 | 1 | NULL | 2007-08-21 | 32 |
| ID | Фамилия | Имя | Город | Вуз |
|---|---|---|---|---|
| 24 | Колесников | Борис | Воронеж | 10 |
| 46 | Никонов | Иван | Воронеж | 10 |
| 74 | Лагутин | Павел | Москва | 22 |
| 108 | Струков | Николай | Москва | 22 |
| 276 | Николаев | Виктор | Воронеж | 10 |
| 328 | Сорокин | Андрей | Орёл | 10 |
| 401 | Смирнова | Ольга | Санкт-Петербург | 12 |
| 512 | Гусев | Игорь | Новосибирск | 11 |
| 620 | Фролов | Сергей | Томск | 15 |
| 705 | Макарова | Анна | Белгород | 14 |
| SUBJ_ID | Название | Часы | Семестр |
|---|---|---|---|
| 10 | Информатика | 56 | 1 |
| 18 | Химия | 40 | 2 |
| 22 | Физика | 34 | 1 |
| 31 | Базы данных | 72 | 5 |
| 43 | Математика | 56 | 2 |
| 56 | История | 34 | 4 |
| 73 | Физкультура | 34 | 5 |
| 94 | Английский | 56 | 3 |
| EXAM_ID | STUDENT_ID | SUBJ_ID | MARK | EXAM_DATE |
|---|---|---|---|---|
| 1 | 1 | 10 | 5 | 2026-01-15 |
| 2 | 1 | 22 | 4 | 2026-01-18 |
| 3 | 3 | 10 | 3 | 2026-01-15 |
| 4 | 3 | 22 | 4 | 2026-01-18 |
| 5 | 2 | 10 | 5 | 2026-01-16 |
| 6 | 4 | 43 | 5 | 2026-06-10 |
| 7 | 5 | 10 | 4 | 2026-01-15 |
| 8 | 6 | 56 | 3 | 2026-06-12 |
| 9 | 8 | 94 | 5 | 2026-01-20 |
| 10 | 9 | 18 | 4 | 2026-06-08 |
| 11 | 10 | 31 | 5 | 2026-01-22 |
| 12 | 12 | 56 | 4 | 2026-06-12 |
| 13 | 13 | 10 | 2 | 2026-01-15 |
| 14 | 14 | 94 | 5 | 2026-01-20 |
| 15 | 17 | 22 | 3 | 2026-01-18 |
| 16 | 7 | 10 | 5 | 2026-01-16 |
| 17 | 11 | 10 | 4 | 2026-01-16 |
| 18 | 15 | 22 | 3 | 2026-01-18 |
| 19 | 18 | 56 | 5 | 2026-06-12 |
| 20 | 16 | 31 | 4 | 2026-01-22 |
| 21 | 1 | 43 | 5 | 2026-06-10 |
| 22 | 12 | 31 | 3 | 2026-01-22 |
| 23 | 6 | 31 | 4 | 2026-01-22 |
| 24 | 4 | 10 | 4 | 2026-01-16 |
Студент 19 (Медведев) специально без строк в EXAM_MARKS и с CITY NULL: на нём проверяют IS NULL, NOT EXISTS и LEFT JOIN … IS NULL.
| LECTURER_ID | SUBJ_ID |
|---|---|
| 24 | 10 |
| 24 | 31 |
| 46 | 22 |
| 46 | 18 |
| 74 | 43 |
| 108 | 56 |
| 276 | 73 |
| 328 | 10 |
| 401 | 94 |
| 512 | 10 |
| 620 | 18 |
| 705 | 56 |
| UNIT_ID | PARENT_ID | UNIT_NAME | UNIVERSITY_ID |
|---|---|---|---|
| 1 | NULL | Ректорат | 10 |
| 2 | 1 | Учебное управление | 10 |
| 3 | 1 | Факультет КНиИТ | 10 |
| 4 | 3 | Кафедра информационных технологий | 10 |
| 5 | 3 | Кафедра математики | 10 |
| 6 | 1 | Факультет ПММ | 10 |
| 7 | 6 | Кафедра механики | 10 |
| 20 | NULL | Ректорат | 22 |
| 21 | 20 | Факультет ВМК | 22 |
| 22 | 21 | Кафедра алгоритмических языков | 22 |
| Задача | SQL Server | SQLite |
|---|---|---|
| Первые N строк | TOP (N) … ORDER BY | LIMIT N |
| Пагинация | OFFSET FETCH | LIMIT … OFFSET |
| Строка сейчас | GETDATE(), SYSDATETIME() | datetime('now') |
| Конкатенация | + или CONCAT | || |
| Авточисло | INT IDENTITY | INTEGER PRIMARY KEY |
| Юникод-литерал | N'текст' | 'текст' UTF-8 |
| Удаление дубликатов строк запроса | DISTINCT | DISTINCT |
| FULL JOIN | есть | эмуляция UNION |
| Процедуры | CREATE PROC | нет |
| Бэкап | BACKUP DATABASE | VACUUM INTO / копия файла |
На экзамене из этого списка задают два вопроса (см. билеты ниже).
На экзамене выдаётся один билет из списка ниже: два теоретических вопроса + одна SQL-задача по UniversityDB. Нажмите на номер билета, чтобы открыть.
NOT EXISTS или LEFT JOIN … IS NULL).GROUP BY, HAVING).SUBJ_LECT).CITY IS NULL (ожидается Медведев, STUDENT_ID=19).UNIVERSITY_ID=10 от UNIT_ID=1.NOT EXISTS или LEFT JOIN … IS NULL).GROUP BY, HAVING).SUBJ_LECT).CITY IS NULL (ожидается Медведев, STUDENT_ID=19).UNIVERSITY_ID=10 от UNIT_ID=1.NOT EXISTS или LEFT JOIN … IS NULL).GROUP BY, HAVING).SUBJ_LECT).CITY IS NULL (ожидается Медведев, STUDENT_ID=19).UNIVERSITY_ID=10 от UNIT_ID=1.